CONTENT Sync
Der lebendige Wissenspool.
n8n Workflow
RAG Synchronisation
Content Sync – Der lebendige Wissenspool
Wann läuft er? Automatisch, täglich – vollständig ohne manuellen Auslöser.
Technischer Ablauf
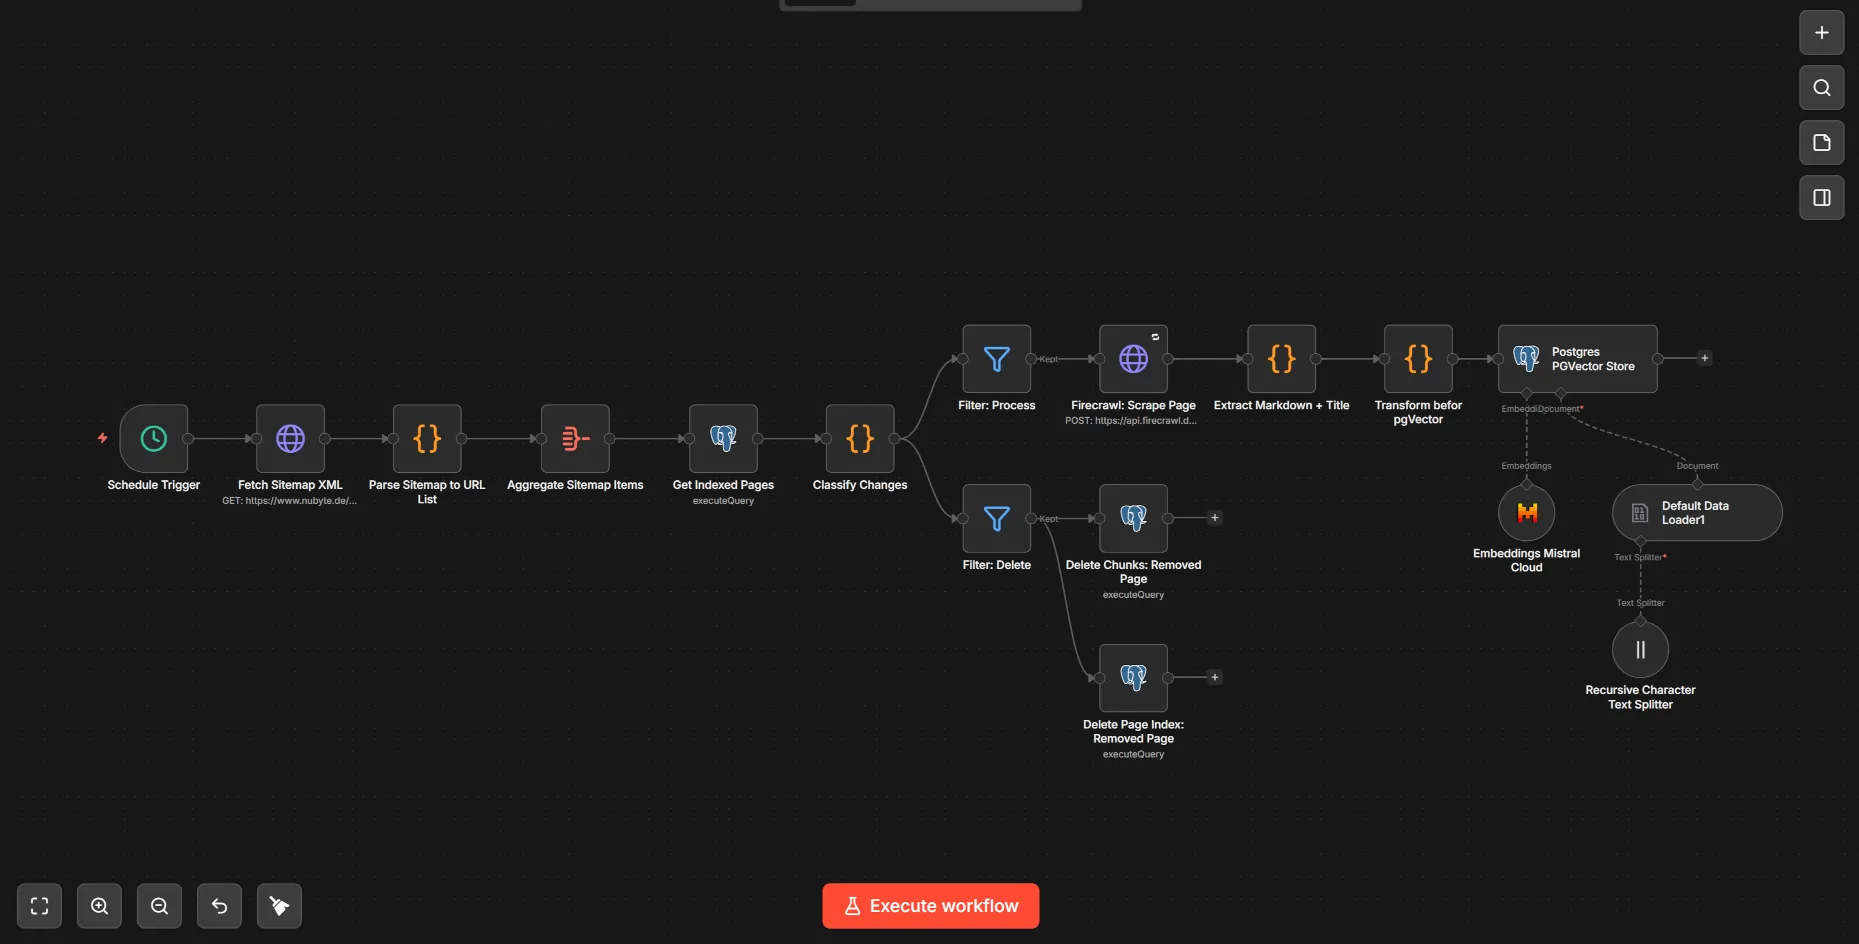
Der Workflow ruft https://www.nubyte.de/sitemap.xml ab und parst alle enthaltenen URLs inklusive ihrer lastmod-Zeitstempel und Prioritäten.
Die geparsten URLs werden mit einer Page Index Postgres-Tabelle abgeglichen. Jede URL wird einer von drei Kategorien zugeordnet:
- NEW – Seite ist im Sitemap, aber noch nicht im Index
- UPDATED – lastmod-Zeitstempel hat sich seit der letzten Indexierung geändert
- DELETED – Seite war im Index, fehlt aber jetzt im Sitemap
Firecrawl scrapt die betreffenden Seiten und gibt den Seiteninhalt als sauberes Markdown zurück – ohne Navigation, Werbebanner oder Footer-HTML.
Das Markdown wird durch einen Recursive Character Text Splitter in überlappende Abschnitte zerlegt (Überlappung: 150 Zeichen, optimiert für semantische Grenzen). Die Mistral-Cloud-API wandelt jeden Chunk in einen hochdimensionalen Embedding-Vektor um.
Chunks + Metadaten (URL, Seitentitel, lastmod, Priorität) + Vektoren werden in eine Page Chunks Tabelle geschrieben.
Für entfernte Seiten werden alle zugehörigen Chunks gelöscht und der Index-Eintrag entfernt.
Mehrwert
Das Herzstück des Chatbots ist sein Wissen über die Website. Ohne diesen Workflow müsste der Chatbot auf allgemeines Modellwissen zurückgreifen – und würde zwangsläufig ungenaue oder veraltete Antworten liefern. Mit diesem Workflow hingegen ist der Chatbot immer auf dem Stand der aktuellen Website: Eine neue Leistungsseite, ein neuer Ratgeber-Artikel oder ein aktualisierter Showcase sind spätestens am nächsten Morgen Teil der Wissensbasis.
Für den Website-Betreiber bedeutet das: Inhalte müssen nur an einer Stelle gepflegt werden – auf der Website selbst. Der Wissenspool des Chatbots aktualisiert sich vollautomatisch.
FAQ
Häufige Fragen
Wie oft wird das Wissen des Chatbots aktualisiert?
Täglich um 03:01 Uhr läuft der Sync automatisch. Neue, geänderte und gelöschte Seiten werden erkannt und entsprechend verarbeitet. Nach der nächsten Sync-Nacht ist NUBY immer auf dem aktuellen Stand – ohne manuellen Eingriff.
Was passiert, wenn sich Inhalte auf der Website ändern?
Workflow 1 erkennt geänderte Seiten anhand der Sitemap-Metadaten. Die bestehenden Chunks werden gelöscht und durch frisch gescrapte, neu eingebettete Chunks ersetzt. So werden veraltete Informationen nicht mehr vom Chatbot beantwortet.
Warum pgVector statt einer klassischen Datenbank?
Klassische Datenbanken suchen nach exakten Treffern. pgVector speichert semantische Embeddings und ermöglicht Ähnlichkeitssuchen: Der Chatbot findet inhaltlich passende Antworten, auch wenn der Nutzer andere Worte verwendet als der Seiteninhalt.
Kann der Workflow auch andere Quellen wie PDFs oder Google Docs einbinden?
Ja – der Workflow ist erweiterbar. Als Basis dient die Website-Sitemap, aber es lassen sich weitere Quellen wie PDF-Uploads, Notion-Seiten oder Google Docs ergänzen. Die Extraktions- und Embedding-Pipeline wird einfach um weitere Quellknoten erweitert.
Jetzt einfach ein unverbindliches Erstgespräch vereinbaren.